A Microsoft és az OpenAI belső iratai szerint az LLM-ek a web tartalmát használják fel
A New York Times szerzői jogi perében felbukkant belső dokumentumok szerint a Microsoft és az OpenAI vezetői elismerték, hogy a nagy nyelvi modelleket meglévő webes tartalmakkal tanították be.
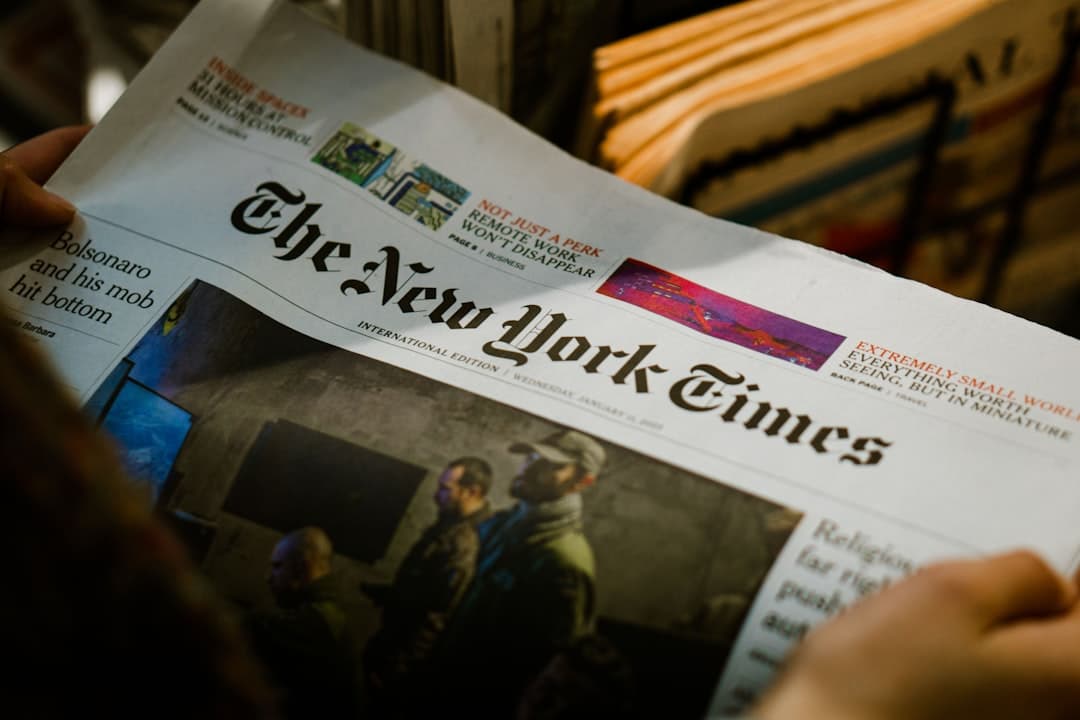
A New York Times által indított, évek óta húzódó szerzői jogi perben felmerült, hogy a Microsoft és az OpenAI vezetői is elismerték: a nagy nyelvi modellek (LLM) „ragadozó technológiák”, amelyek „a valaha volt legnagyobb munkaerő-lopáson” alapulnak. Egy belső Microsoft-dokumentum szerint a generatív AI termékek egy „döglődő ciklusban” ölik meg „az egész webet”. (404 Media)
A belső dokumentumok tanúsága
A bírósági iratból kiderül, hogy a Microsoft és az OpenAI vezetői dokumentumokban és kihallgatásokon tettek olyan kijelentéseket, amelyek eddig nagyrészt titkosak vagy szerkesztettek voltak. A dokumentumok szerint az LLM-eket nagyrészt ellopott tartalommal tanították be, és ezek a modellek egzisztenciális kockázatot jelentenek az emberi alkotókra, művészekre és médiacégekre nézve.
„Milliók fogják hamarosan csodálatos lopásnak tartani, ahogy a nagy modellek felzabálják az összes munkájukat” — olvasható egy belső Microsoft-dokumentumban, amely hozzáteszi: „szinte senki sem szándékozott úgy tartalmat létrehozni, hogy azt ilyen módon használják fel, és ezért nem is fizetnek nekik.”
Az üzleti modell és a kattintások csökkenése
Jason Kint, a Digital Content Next nevű szervezet vezérigazgatója, amely digitális médiacégeket képvisel, bukkant rá az iratra. A bírósági beadvány egy belső Microsoft-dokumentumra hivatkozik, amely szerint az AI-termékek az emberi tartalomalkotóktól lopnak, majd „megeszik” azokat a kattintásokat, amelyeket az általuk ellopott források generálnának, ezzel tönkretéve üzleti modelljeiket.
„Az AI tartalomstratégiánk elindított egy »döglődő ciklust«, amely egyszerre rontja modelljeink teljesítményét és az egész webet: rendkívül szokatlan, hogy egy végtermék veszélyezteti alapvető beszállítóinak gazdasági alapjait, de ez a helyzet, amelyet LLM-üzletágunkkal teremtettünk meg a »tartalmi ellátási láncunk« tekintetében” — áll a dokumentumban.
A Microsoft vezérigazgatója, Satya Nadella és más vezetők is vallották, hogy a New York Times és más híroldalak tartalmának ellopása után a híroldalakra irányuló kattintások drasztikusan, több mint 90 százalékkal estek vissza a Bing keresőben. Dokumentumok szerint az OpenAI „készített egy feltörést a New York Times fizetőfalának megkerülésére”, amire Greg Brockman, az OpenAI társalapítója azt válaszolta: „ah, nice.”
Brent Hecht, a Microsoft egyik vezetője azt írta, hogy az LLM-ek „a gazdasági érték leosztása nélküli tartalom ellopásával […] szükségszerűen veszélyeztetik a tartalomalkotók gazdasági stabilitását”. Jack Clark, az OpenAI politikai igazgatója pedig arról írt, hogy a cég „olyan rendszereket hoz létre, amelyek helyettesítik azokat az embereket, akik a társadalom »kultúráját« alkotják”.
Az OpenAI magát „egzisztenciális fenyegetésként” jellemezte a hírkiadókra nézve, és egy OpenAI szoftvermérnök vallomása szerint „nem számít, milyen kiemelten jelenítjük meg a linkeket, a felhasználók nem fognak kattintani”.
A bírósági iratból az is kiderül, hogy az OpenAI és a Microsoft ügyvédei azzal próbálnak érvelni, hogy modelljeik betanítása tisztességes felhasználásnak és transzformatívnak minősül a szerzői jogi törvények alapján. Belsőleg azonban a vezetők is tudják, hogy amit építettek, az lopott tartalomra épül, és termékeik „megeszik” azokat a forrásokat, ahonnan loptak, ezzel pedig elpusztítják az internetet.