Kutatás
Pixel-szintű vizuális megértést hozhat a képpont- és szószimbólumokat egyesítő új AI modell
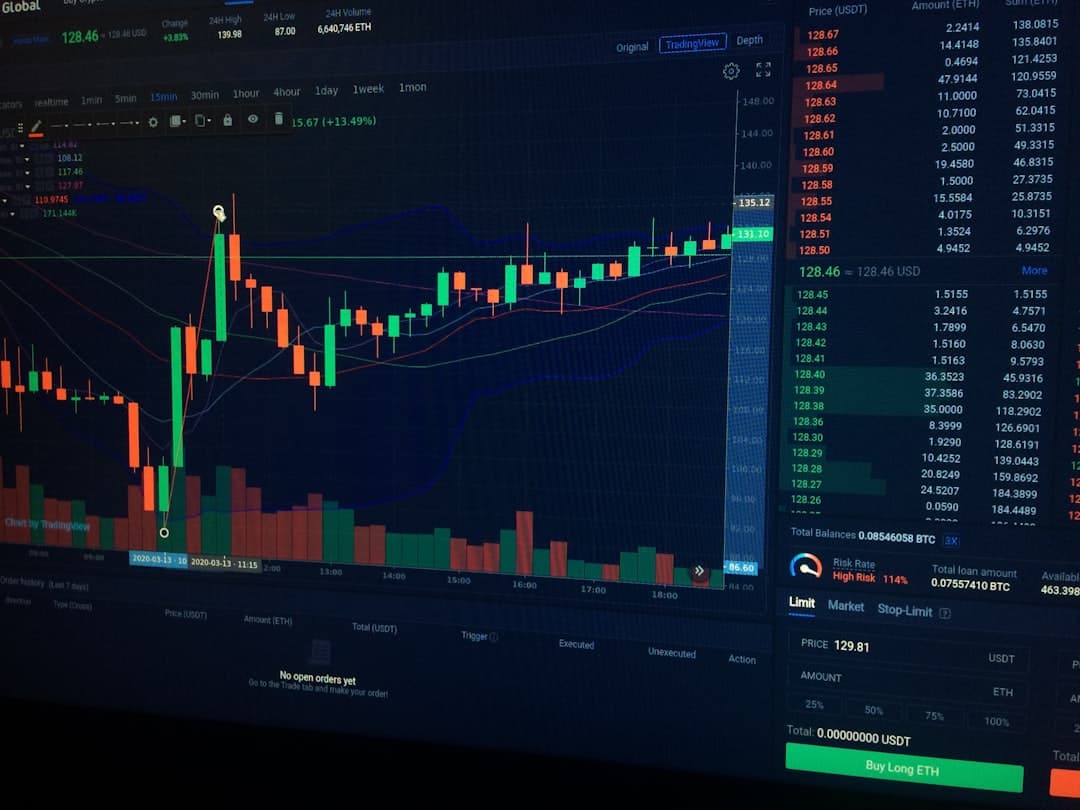
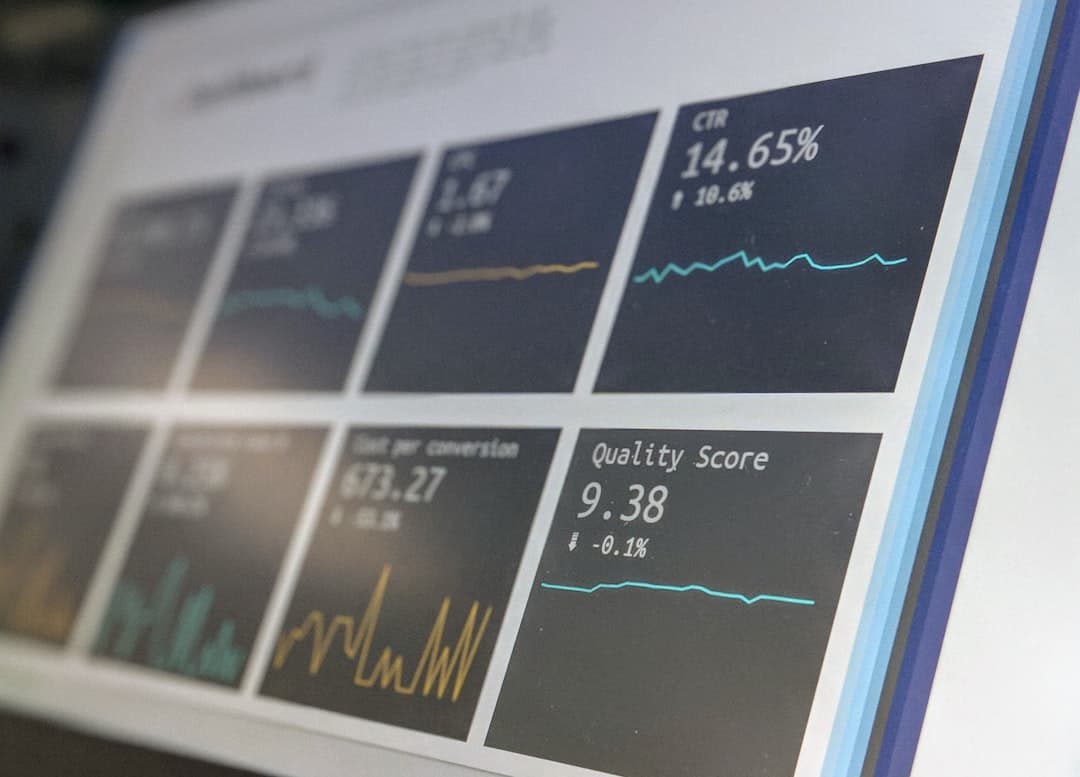
A jelenlegi nyílt forráskódú multimodális modellek nehezen ismerik fel a képeken lévő apró szövegeket vagy számokat, ezen a problémán segíthet az új megközelítés.
AI-összefoglaló