Kutatás
Új diffúziós modell 27%-kal csökkenti a táblázatos adatok hibáit
A GATD modell 27%-kal csökkenti a táblázatos adatok hibáit, miközben akár 25-szer kevesebb paramétert használ a klasszikus feladatoknál.
AI-összefoglaló
Friss kutatási eredmények és tudományos áttörések a mesterséges intelligencia világából
A GATD modell 27%-kal csökkenti a táblázatos adatok hibáit, miközben akár 25-szer kevesebb paramétert használ a klasszikus feladatoknál.
A CL-DMDF nevű új AI-modell kontrasztív tanulást és egyedi figyelmi mechanizmust használ a hiányzó multimodális adatok hatékony kezelésére.
Az AI-ügynökök központosított irányítás nélkül, gazdasági versennyel és vagyoncserével tanulnak, önszerveződő intelligenciát hozva létre — derül ki egy új kutatásból.
Az új diagnosztikai keretrendszer 48,6%-ról 90,2%-ra javítja a HOI-detektorok pontosságát orvosi képzési videókon.
A MetaWorld keretrendszer egyetlen videóból képes többügynökös világmodelleket létrehozni, megoldva az adat-szűkösség és a szinkronizációs problémákat.

Az AI-ügynökök nem csak a feladatok elvégzését, hanem a tétlenség kompetenciáját is méri az új kutatás, amely 89%-ban blokkolja a veszélyes lépéseket.
A nagy nyelvi modellek tévedései kimutathatók a belső rétegekben. A Stanford és a Google Robotics kutatói fedezték fel ezt.

Az AI-cégek engedély nélkül használják a publikált matematikai kutatásokat, ami veszélyezteti a bizonyítások integritását és az etikai normákat — figyelmeztet a Leideni Nyilatkozat, melyet a Nemzetközi Matematikai Unió is támogat.
A kutatásban egy új mélytanulási keretrendszerrel, a DefocusTrackerAI-val érték el a 0.1 pixeles pontosságot. A modell a YOLOv9 objektumdetektáló modellre épül, és szinesztetikus adathalmazon lett betanítva.
Egy új tanulmány integrálja a világmodellek építészeti, módszertani és alkalmazási irányzatait az emberi intelligenciát megközelítő AI-ügynökök fejlesztéséhez. A kutatás célja, hogy egységes keretrendszert teremtsen a területen belüli sokféle megközelítésnek.
A kutatók szerint az ATOM keretrendszer hatékonyabban képes kezelni a molekulatervezés során felmerülő ellentétes célokat. Az új módszerrel elérhető jobb Pareto-lefedettség és hipervolumen jelentősen javíthatja a molekulatervezést.
A legfejlettebb orvosi LLM-ek is súlyos hibákat véthetnek kritikus klinikai helyzetekben. 11 kortárs LLM-et teszteltek 690 klinikailag megalapozott forgatókönyvön keresztül.
Az új keretrendszer a feladatok szabályait adva arra kényszeríti a modelleket, hogy maguk szerezzenek információt a környezetből, majd ezek alapján hozzanak döntést.
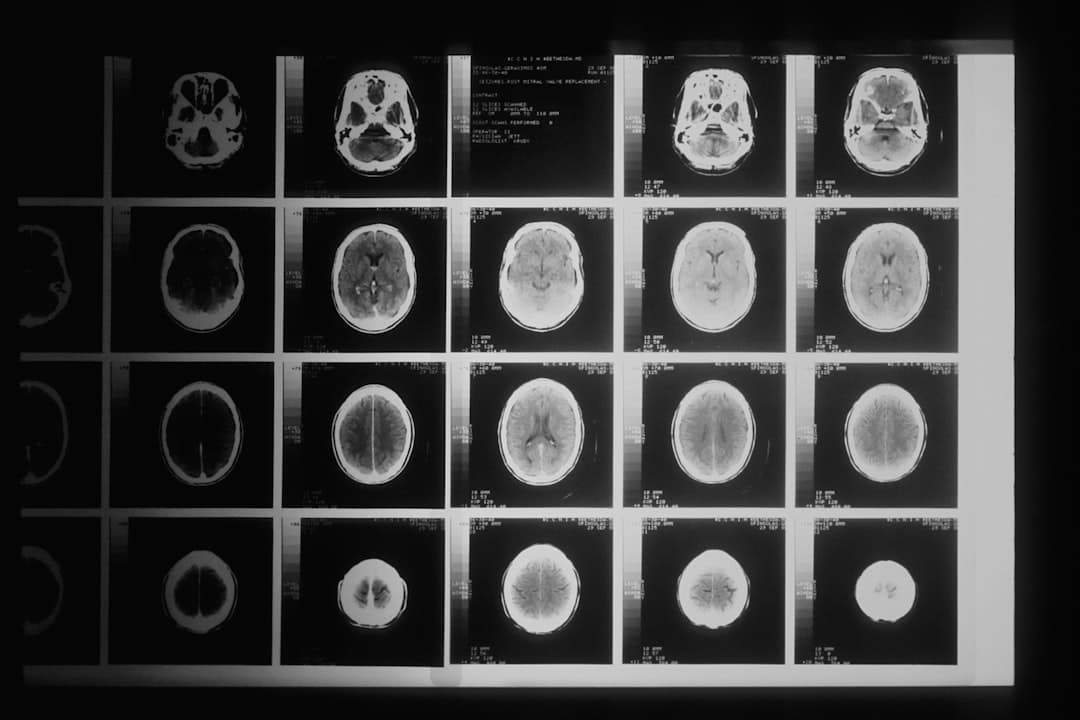
Az új GCSER-UNet modell 95%-os dice score-t ért el az agydaganatok szegmentálásában, ami jelentős előrelépés a korábbi 94%-os csúcshoz képest.
A ReGuLaR keretrendszer a vizuális bizonyítékokhoz köti a modell belső érvelését, javítva a pontosságot.
Egy új bangla nyelvű kutatás kimutatta, hogy az angol nyelvű utasítások a globális narratívákat részesítik előnyben a helyi kontextusokkal szemben az LLM-ekben. A kutatás szerint ez csökkenti a helyi perspektívák lefedettségét.
A Stanford és a Google kutatói szerint a legtöbb LLM rosszul van kalibrálva rangsorolásnál. Ez befolyásolhatja a megbízhatóságukat.
A DisjunctiveNet nevű új keretrendszer lehetővé teszi, hogy a neurális hálózatok pontosan betartsák a logikai és lineáris szabályokat, miközben megőrzik a tanulási képességüket.
A tengeri hajózási adatokban előforduló rendellenességek, mint a sebességugrások vagy pozícióeltérések kiszűrésére új minőségi mutatót, az MADQI-t fejlesztették ki. A módszer 80,37%-os hatékonyságot ért el az AIS-adatokon.
A Stanford-kutatás szerint a két legjobb kódoló AI képességei 50%-ra csökkentek, amikor együttműködtek. A CooperBench tesztben a csapatmunka hátrányosnak bizonyult.
A MAVEN nevű új szimbolikus keretrendszer 23%-kal növeli az AI-ügynökök pontosságát a bonyolult feladatok megoldásában, miközben a számítási költségeket tizedére csökkenti.
Tetszik az oldal? Támogasd a fejlesztést
Az AI Forradalom egy automatizált pipeline: napi adatgyűjtés, LLM-feldolgozás és infrastruktúra fenntartása valódi költségekkel jár. Ha értékesnek találod a tömör, naprakész AI-összefoglalókat, egy kávé sokat segít.