Oxford engedélyezi az OpenAI-nak könyvtári adatai használatát AI-képzéshez
Az Oxfordi Egyetem Bodleian Könyvtárának digitalizált anyagai kerülnek az OpenAI képzési halmazába, amelyeket a ChatGPT mögött álló cég AI-modelljeinek betanítására használnak fel.
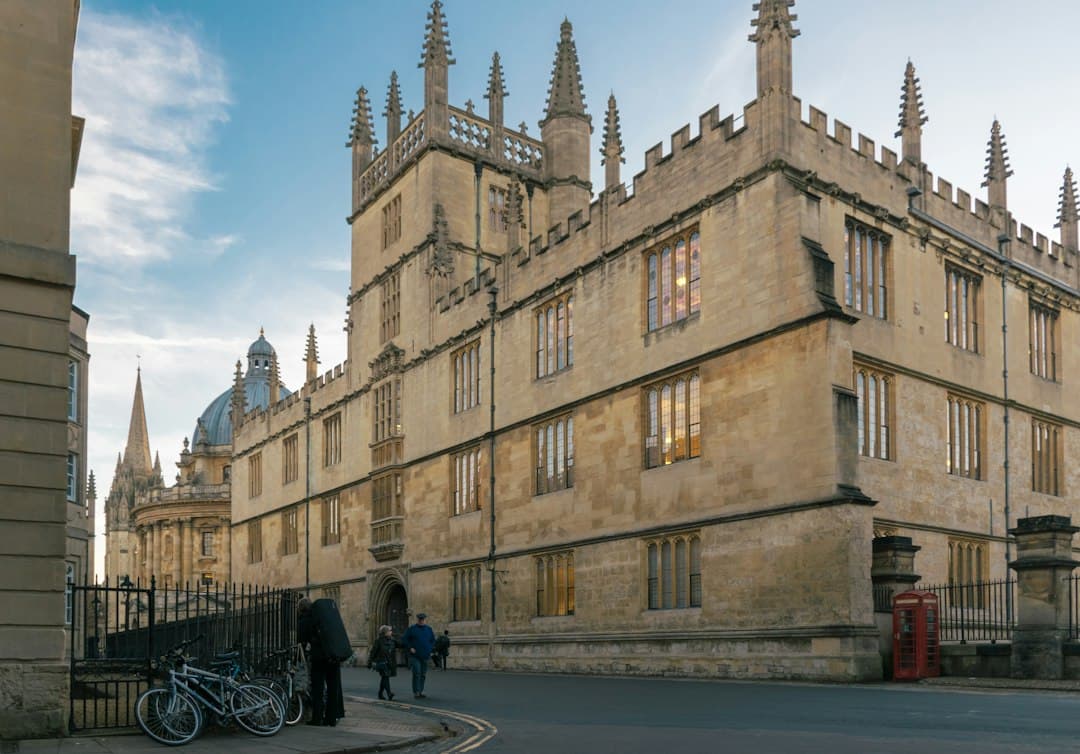
Az OpenAI belső dokumentumai szerint a cég a Bodleian Könyvtár anyagainak felhasználásával bővíti képzési halmazát. Az egyetem és a vállalat 2025 márciusában jelentette be a partnerséget, amelynek keretében a tartalmak szélesebb körben lettek elérhetővé diákok és kutatók számára. (Guardian AI)
Az OpenAI szóvivője szerint büszkék arra, hogy „a mai AI-modellek megőrzik a világ történelmi tudását a jövő számára”. Hozzátette, hogy a technológia egymilliárdos felhasználóbázisa miatt fontos, hogy az különböző kultúrákat, történelmeket és nézőpontokat tükrözzön.
Aggodalmak és spekulációk
Az Oxfordi Egyetem belső értekezletein, amelyeket egy információszabadság-kérelem révén szereztek meg, a személyzet aggodalmakat fogalmazott meg az OpenAI-val való partnerség reputációs kockázataival és a technológia energiaigénye miatt az egyetem környezeti kötelezettségvállalásaira gyakorolt hatásával kapcsolatban.
Könyvkereskedők jelentései szerint megnőtt az igény ritka, 18. századi mezőgazdasági eszközökről szóló útmutatókra vagy az 1950-es évekbeli autovezetőkről szóló életrajzokra. Másodkézből származó könyvek tulajdonosai arra spekulálnak, hogy ezek a címek, mivel valószínűleg nem léteznek digitalizált formában online, friss adatokat jelentenek az AI-modellek következő generációja számára.
Nemzetközi minták és jövőbeli tervek
Az OpenAI hasonló megállapodásokat kötött amerikai kutatókönyvtárakkal, mint például a Boston Public Library, a Caltech, az MIT és az University of Michigan, a NextGenAI projekt keretében. Az Oxford az Egyesült Királyság egyetlen tagja a projektnek. 2025 júniusára 125 000 kép került megosztásra az OpenAI-val a történelmi disszertációkból, köztük 19. és 20. századi európai és amerikai egyetemek PhD-dolgozataiból. További beolvasott szövegek közé tartozik egy ritka, 16. századi „broadside ballad” gyűjtemény, amely dalokat és kottát tartalmazott.
A tervek között szerepel 18. századi ír állami iratok, Marie Edgeworth ír regényíró magánlevelei és Dorothy Hodgkin penicillin-jegyzetfüzeteinek digitalizálása is. Az OpenAI szerződése az Oxforddal a Bodleian 23 milliós gyűjteményének tömeges digitalizálását is felveti, valamint egy „Ask the Bod” chatbot létrehozását.
Az egyetem álláspontja
Az Oxfordi Egyetem szóvivője szerint a digitalizált szöveg mennyisége „mérsékelt méretű”, és csak szerzői jogon kívüli anyagokra terjed ki. A Bodleian megtartja a szkennelt anyagok jogait, és azokat néhány hónapon belül megkezdi online közzétenni. Elutasították azt a javaslatot, hogy a gépi tanulási elemet eltitkolták volna a nyilvánosság és a diákok elől.
A digitalizálás volt az egyetem elsődleges érdeke, de a személyzet nyitott volt arra, hogy a projekt képzési adatokat is szolgáltat. A Bodleian gyűjteményei az üzlet keretében sértetlenek maradnak, ellentétben más könyvbeszerzésekkel, ahol a könyveket szkennelés után pulppá dolgozzák fel.
Az OpenAI közeli riválisa, az Anthropic, több tízmillió dollárt költött könyvek beszerzésére és gerincük eltávolítására, hogy tartalmukat be tudják szkennelni, mielőtt pulppá dolgozzák fel őket. Az Oxford szóvivője megjegyezte: „Az OpenAI-val kötött projekt révén digitalizált anyagok mérsékelt méretűek, szerzői jogon kívüliek, és az OpenAI anyaghasználata nem kizárólagos.
A Bodleian könyvtárak megtartják a jogot arra is, hogy maguk tegyék elérhetővé a digitalizált anyagokat, és a könyvtár a következő néhány hónapban megkezdi ezek közzétételét online, ahogy más digitalizálási partnerségek kimeneteivel is tesszük. A projekt valójában lehetővé teszi a Bodleian számára, hogy az anyagot szélesebb körben hozzáférhetővé tegye azok számára, akiknek egyébként nehéz lett volna hozzáférniük.”