Egy nap alatt 160%-kal nőtt az agent-elkötelezettség az Amplitude új AI-rendszerétől
Az Amplitude Wave nevű proaktív termékagentje a főoldalon egy nap alatt 160%-os elkötelezettség-növekedést hozott a kontrollcsoporthoz képest — a cég saját, belső tesztje szerint.
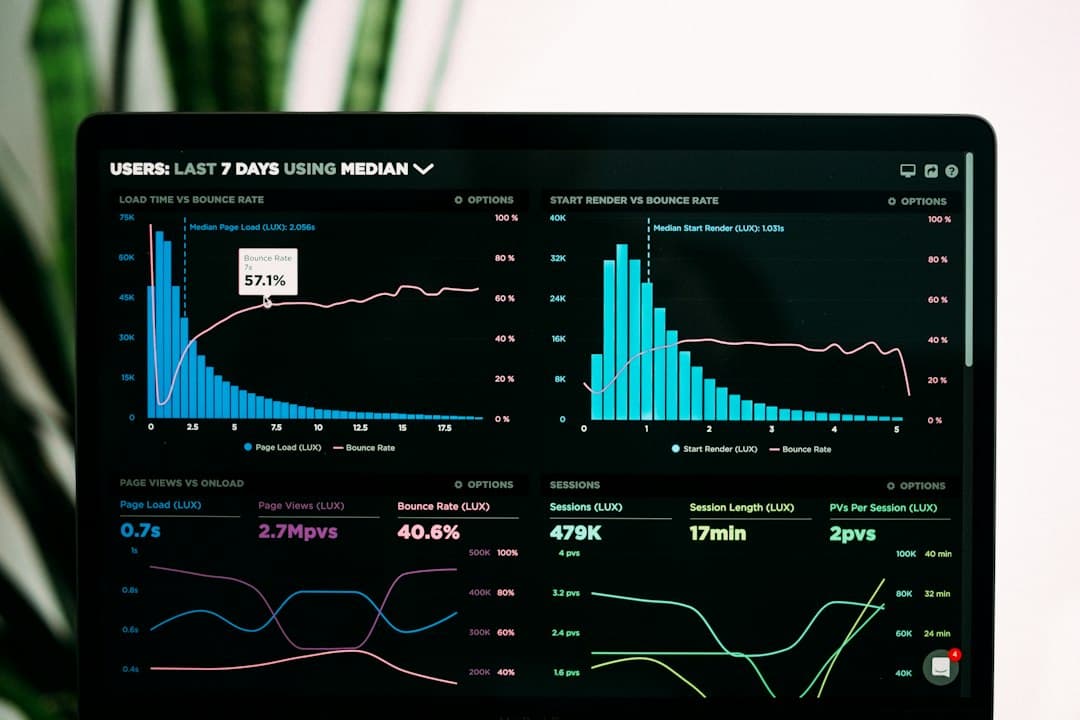
A Wave az Amplitude proaktív termékagentje: a csapatok megadják a termékterületet, a célokat és a metrikákat, a rendszer pedig az Amplitude adatait, a session replay-eket, az ügyfél-visszajelzéseket és a kódot összefogva azonosítja és priorizálja a lehetőségeket — írja az OpenAI ügyfélsztorija.
A munkafolyamat mögött az Amplitude különböző OpenAI-modelleket használ különböző feladatokra. A GPT-6.1 Sol a lehetőségkezelőt és a mélyebb vizsgálatokat támogatja a kódban és az adatokban, a GPT-6 Luna a gyakori, alacsonyabb költségű feladatokat végzi, például a kód átvizsgálását és kisebb értékelő ellenőrzéseket, a GPT-Image-2.5 Flare pedig termékmakettek generálására szolgál, a session replay-ek képernyőfotóit vizuális referenciaként használva.
A 160%-os elkötelezettség-növekedés háttere
Az Amplitude a Wave-et a saját főoldalán tesztelte, ahol általános javaslatkártyák segítettek elindítani a beszélgetést az AI-agenttel. A rendszer azt találta, hogy a felhasználók gyakran megkerülték ezeket: a 100 session replay-ből álló mintában 80 felhasználó saját kérdést gépelt be, és csak 12 választott javaslatot.
A Wave ezután a legutóbbi diagramok, dashboardok vagy az előző oldal alapján személyre szabott kártyákat javasolt, technikai tervvel együtt, amely megtartja a szabad gépelés lehetőségét. A csapat rövid felülvizsgálat után a munkát kódoló agentnek adta át, és A/B-tesztet futtatott. Az Amplitude által megosztott eredmény szerint az üzenetek száma a kártyákon keresztül egy nap után 160%-kal nőtt a kontrollhoz képest — írja az OpenAI.
Megfelelő modell minden feladathoz
A Wave feladatai eltérő igényeket támasztanak a modellekkel szemben: a mélyvizsgálat erős érvelést és jól alátámasztott következtetéseket kíván, a sokszor ismételt apró ellenőrzésnek viszont gyorsnak és olcsónak kell lennie. Az Amplitude feladatonként értékeli a minőséget, a késleltetést és a költséget, és ennek alapján rendeli hozzá a modelleket.
A Wave lehetőségvizsgáló moduljának értékelésében a GPT-6.1 Sol összesítésben 4,06-ot kapott az ötfokú skálán, míg három alternatív modell 3,62, 3,52 és 2,94 pontot ért el. A Data Science Agent értékelésében a GPT-6.1 Sol 67,5 pontot kapott a százból, egy másik vezető modell 69,3 pontjával szemben, de dispatchenként átlagosan 1,28 dollárba került, szemben a másik modell 2,63 dolláros költségével — közölte az OpenAI.
Az Amplitude szerint a GPT-6.1 Sol átlagos modellköltsége dispatchenként 51%-kal alacsonyabb volt. A képgeneráló modell 15 lehetőségen végzett értékelésében a wireframe-ek esetében 80,3 pontot ért el a százból, míg egy másik képgeneráló modell 63,9 pontot.
Emberi döntés a kiadás előtt
A csapatok a Wave-et béta-verzióban már több iparágban használják. A rendszer a session- és analitikai adatokat elemzi, majd javított megoldási javaslatokat, technikai tervet és elfogadási kritériumokat állít össze. A csapatok szabályozhatják az automatizálás mértékét: a hibajavításokat általában egyenesen a kódoló agentnek küldik, az új funkciókat és nagyobb fogadásokat viszont emberi felülvizsgálat követi.
Az ügyfelek által indított kísérletek, jelzőfelek és útmutatók közül minden negyedik még azon a napon élesedett, amikor a Wave felismerte a lehetőséget, fele négy napon belül, kétharmada egy héten belül. A forrás szerint az Amplitude 1–2 napos átfutási időt becsül egy termékfejlesztésre. A mintavétel részletei sem szerepelnek a forrásban.
Jacob Newman, az Amplitude főállású AI-termékmenedzsere szerint az elképzelés egy egységes platform, ahol az agentek nagy mennyiségű session replay-t, analitikát és kódot vizsgálnak át, hogy termékfejlesztési lehetőségeket találjanak. Spenser Skates, az Amplitude vezérigazgatója szerint a cél az, hogy a termékek önmaguktól fejlődjenek, ahogy a cégek ma szoftvert építenek.